---
sidebar: heading
copy:
disableCopy: true
---

## Java的特点
**Java是一门é¢å‘对象的编程è¯è¨€**。é¢å‘对象和é¢å‘过程的区别å‚考下一个问题。
**Java具有平å°ç‹¬ç«‹æ€§å’Œç§»æ¤æ€§**。
- Java有一å¥å£å·ï¼š`Write once, run anywhere`,一次编写ã€åˆ°å¤„è¿è¡Œã€‚这也是Javaçš„é…力所在。而实现这ç§ç‰¹æ€§çš„æ£æ˜¯Java虚拟机JVM。已编译的Java程åºå¯ä»¥åœ¨ä»»ä½•å¸¦æœ‰JVMçš„å¹³å°ä¸Šè¿è¡Œã€‚ä½ å¯ä»¥åœ¨windowså¹³å°ç¼–写代ç ,然åŽæ‹¿åˆ°linux上è¿è¡Œã€‚åªè¦ä½ 在编写完代ç åŽï¼Œå°†ä»£ç 编译æˆ.class文件,å†æŠŠclass文件打æˆJava包,这个jar包就å¯ä»¥åœ¨ä¸åŒçš„å¹³å°ä¸Šè¿è¡Œäº†ã€‚
**Java具有稳å¥æ€§**。
- Java是一个强类型è¯è¨€ï¼Œå®ƒå…许扩展编译时检查潜在类型ä¸åŒ¹é…问题的功能。Javaè¦æ±‚显å¼çš„方法声明,它ä¸æ”¯æŒCé£Žæ ¼çš„éšå¼å£°æ˜Žã€‚è¿™äº›ä¸¥æ ¼çš„è¦æ±‚ä¿è¯ç¼–译程åºèƒ½æ•æ‰è°ƒç”¨é”™è¯¯ï¼Œè¿™å°±å¯¼è‡´æ›´å¯é 的程åºã€‚
- 异常处ç†æ˜¯Javaä¸ä½¿å¾—程åºæ›´ç¨³å¥çš„å¦ä¸€ä¸ªç‰¹å¾ã€‚异常是æŸç§ç±»ä¼¼äºŽé”™è¯¯çš„异常æ¡ä»¶å‡ºçŽ°çš„ä¿¡å·ã€‚使用`try/catch/finally`è¯å¥ï¼Œç¨‹åºå‘˜å¯ä»¥æ‰¾åˆ°å‡ºé”™çš„处ç†ä»£ç ,这就简化了出错处ç†å’Œæ¢å¤çš„任务。
## Java 与 C++ 的区别
- Java 是纯粹的é¢å‘对象è¯è¨€ï¼Œæ‰€æœ‰çš„对象都继承自 java.lang.Object,C++ 兼容 C ,ä¸ä½†æ”¯æŒé¢å‘对象也支æŒé¢å‘过程。
- Java 通过虚拟机从而实现跨平å°ç‰¹æ€§ï¼Œ C++ ä¾èµ–于特定的平å°ã€‚
- Java 没有指针,它的引用å¯ä»¥ç†è§£ä¸ºå®‰å…¨æŒ‡é’ˆï¼Œè€Œ C++ 具有和 C ä¸€æ ·çš„æŒ‡é’ˆã€‚
- Java 支æŒè‡ªåŠ¨åžƒåœ¾å›žæ”¶ï¼Œè€Œ C++ 需è¦æ‰‹åŠ¨å›žæ”¶ã€‚
- Java ä¸æ”¯æŒå¤šé‡ç»§æ‰¿ï¼Œåªèƒ½é€šè¿‡å®žçŽ°å¤šä¸ªæŽ¥å£æ¥è¾¾åˆ°ç›¸åŒç›®çš„,而 C++ 支æŒå¤šé‡ç»§æ‰¿ã€‚
## é¢å‘对象和é¢å‘过程的区别?
é¢å‘对象和é¢å‘过程是一ç§è½¯ä»¶å¼€å‘æ€æƒ³ã€‚
- é¢å‘过程就是分æžå‡ºè§£å†³é—®é¢˜æ‰€éœ€è¦çš„æ¥éª¤ï¼Œç„¶åŽç”¨å‡½æ•°æŒ‰è¿™äº›æ¥éª¤å®žçŽ°ï¼Œä½¿ç”¨çš„时候ä¾æ¬¡è°ƒç”¨å°±å¯ä»¥äº†ã€‚
- é¢å‘对象是把构æˆé—®é¢˜äº‹åŠ¡åˆ†è§£æˆå„个对象,分别设计这些对象,然åŽå°†ä»–们组装æˆæœ‰å®Œæ•´åŠŸèƒ½çš„系统。é¢å‘过程åªç”¨å‡½æ•°å®žçŽ°ï¼Œé¢å‘对象是用类实现å„个功能模å—。
以五å棋为例,é¢å‘过程的设计æ€è·¯å°±æ˜¯é¦–先分æžé—®é¢˜çš„æ¥éª¤ï¼š
1ã€å¼€å§‹æ¸¸æˆï¼Œ2ã€é»‘å先走,3ã€ç»˜åˆ¶ç”»é¢ï¼Œ4ã€åˆ¤æ–输赢,5ã€è½®åˆ°ç™½å,6ã€ç»˜åˆ¶ç”»é¢ï¼Œ7ã€åˆ¤æ–输赢,8ã€è¿”回æ¥éª¤2,9ã€è¾“出最åŽç»“果。
把上é¢æ¯ä¸ªæ¥éª¤ç”¨åˆ†åˆ«çš„函数æ¥å®žçŽ°ï¼Œé—®é¢˜å°±è§£å†³äº†ã€‚
而é¢å‘对象的设计则是从å¦å¤–çš„æ€è·¯æ¥è§£å†³é—®é¢˜ã€‚整个五å棋å¯ä»¥åˆ†ä¸ºï¼š
1. 黑白åŒæ–¹
2. 棋盘系统,负责绘制画é¢
3. 规则系统,负责判定诸如犯规ã€è¾“èµ¢ç‰ã€‚
黑白åŒæ–¹è´Ÿè´£æŽ¥å—用户的输入,并告知棋盘系统棋å布局å‘生å˜åŒ–,棋盘系统接收到了棋åçš„å˜åŒ–çš„ä¿¡æ¯å°±è´Ÿè´£åœ¨å±å¹•ä¸Šé¢æ˜¾ç¤ºå‡ºè¿™ç§å˜åŒ–,åŒæ—¶åˆ©ç”¨è§„则系统æ¥å¯¹æ£‹å±€è¿›è¡Œåˆ¤å®šã€‚
## JDK/JRE/JVM三者的关系
**JVM**
英文å称(Java Virtual Machine),就是我们耳熟能详的 Java 虚拟机。Java 能够跨平å°è¿è¡Œçš„æ ¸å¿ƒåœ¨äºŽ JVM 。

所有的java程åºä¼šé¦–先被编译为.class的类文件,这ç§ç±»æ–‡ä»¶å¯ä»¥åœ¨è™šæ‹Ÿæœºä¸Šæ‰§è¡Œã€‚也就是说class文件并ä¸ç›´æŽ¥ä¸Žæœºå™¨çš„æ“作系统交互,而是ç»è¿‡è™šæ‹Ÿæœºé—´æŽ¥ä¸Žæ“作系统交互,由虚拟机将程åºè§£é‡Šç»™æœ¬åœ°ç³»ç»Ÿæ‰§è¡Œã€‚
针对ä¸åŒçš„系统有ä¸åŒçš„ jvm 实现,有 Linux 版本的 jvm 实现,也有Windows 版本的 jvm 实现,但是åŒä¸€æ®µä»£ç 在编译åŽçš„å—节ç æ˜¯ä¸€æ ·çš„ã€‚è¿™å°±æ˜¯Java能够跨平å°ï¼Œå®žçŽ°ä¸€æ¬¡ç¼–写,多处è¿è¡Œçš„åŽŸå› æ‰€åœ¨ã€‚
**JRE**
英文å称(Java Runtime Environment),就是Java è¿è¡Œæ—¶çŽ¯å¢ƒã€‚我们编写的Java程åºå¿…é¡»è¦åœ¨JREæ‰èƒ½è¿è¡Œã€‚它主è¦åŒ…å«ä¸¤ä¸ªéƒ¨åˆ†ï¼ŒJVM å’Œ Java æ ¸å¿ƒç±»åº“ã€‚

JRE是Javaçš„è¿è¡ŒçŽ¯å¢ƒï¼Œå¹¶ä¸æ˜¯ä¸€ä¸ªå¼€å‘环境,所以没有包å«ä»»ä½•å¼€å‘工具,如编译器和调试器ç‰ã€‚
å¦‚æžœä½ åªæ˜¯æƒ³è¿è¡ŒJava程åºï¼Œè€Œä¸æ˜¯å¼€å‘Java程åºçš„è¯ï¼Œé‚£ä¹ˆä½ åªéœ€è¦å®‰è£…JREå³å¯ã€‚
**JDK**
英文å称(Java Development Kit),就是 Java å¼€å‘工具包
å¦è¿‡Javaçš„åŒå¦ï¼Œéƒ½åº”该安装过JDK。当我们安装完JDK之åŽï¼Œç›®å½•ç»“æž„æ˜¯è¿™æ ·çš„
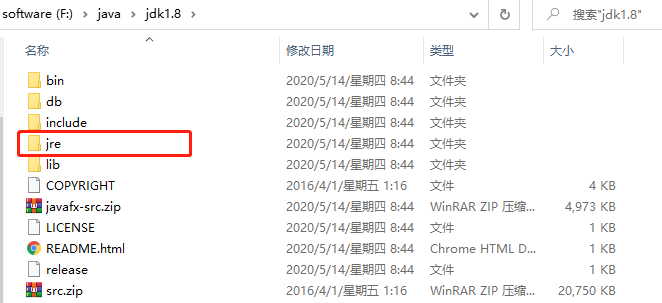
å¯ä»¥çœ‹åˆ°ï¼ŒJDK目录下有个JRE,也就是JDKä¸å·²ç»é›†æˆäº† JRE,ä¸ç”¨å•ç‹¬å®‰è£…JRE。
å¦å¤–,JDKä¸è¿˜æœ‰ä¸€äº›å¥½ç”¨çš„工具,如jinfo,jps,jstackç‰ã€‚
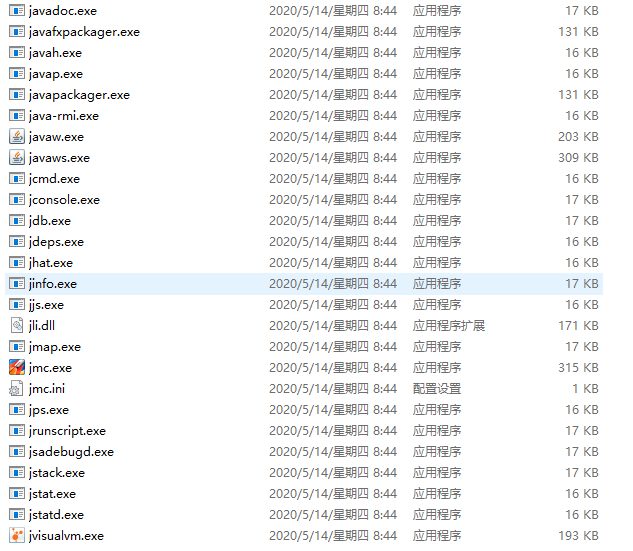
最åŽï¼Œæ€»ç»“一下JDK/JRE/JVM,他们三者的关系
**JRE = JVM + Java æ ¸å¿ƒç±»åº“**
**JDK = JRE + Java工具 + 编译器 + 调试器**

## é¢å‘对象有哪些特性?
é¢å‘对象四大特性:å°è£…,继承,多æ€ï¼ŒæŠ½è±¡
1ã€å°è£…就是将类的信æ¯éšè—在类内部,ä¸å…许外部程åºç›´æŽ¥è®¿é—®ï¼Œè€Œæ˜¯é€šè¿‡è¯¥ç±»çš„方法实现对éšè—ä¿¡æ¯çš„æ“作和访问。 良好的å°è£…能够å‡å°‘耦åˆã€‚
2ã€ç»§æ‰¿æ˜¯ä»Žå·²æœ‰çš„ç±»ä¸æ´¾ç”Ÿå‡ºæ–°çš„ç±»ï¼Œæ–°çš„ç±»ç»§æ‰¿çˆ¶ç±»çš„å±žæ€§å’Œè¡Œä¸ºï¼Œå¹¶èƒ½æ‰©å±•æ–°çš„èƒ½åŠ›ï¼Œå¤§å¤§å¢žåŠ ç¨‹åºçš„é‡ç”¨æ€§å’Œæ˜“维护性。在Javaä¸æ˜¯å•ç»§æ‰¿çš„,也就是说一个åç±»åªæœ‰ä¸€ä¸ªçˆ¶ç±»ã€‚
3ã€å¤šæ€æ˜¯åŒä¸€ä¸ªè¡Œä¸ºå…·æœ‰å¤šä¸ªä¸åŒè¡¨çŽ°å½¢å¼çš„能力。在ä¸ä¿®æ”¹ç¨‹åºä»£ç 的情况下改å˜ç¨‹åºè¿è¡Œæ—¶ç»‘定的代ç 。实现多æ€çš„三è¦ç´ :继承ã€é‡å†™ã€çˆ¶ç±»å¼•ç”¨æŒ‡å‘å类对象。
- é™æ€å¤šæ€æ€§ï¼šé€šè¿‡é‡è½½å®žçŽ°ï¼Œç›¸åŒçš„方法有ä¸åŒçš„åƒæ•°åˆ—表,å¯ä»¥æ ¹æ®å‚æ•°çš„ä¸åŒï¼Œåšå‡ºä¸åŒçš„处ç†ã€‚
- 动æ€å¤šæ€æ€§ï¼šåœ¨åç±»ä¸é‡å†™çˆ¶ç±»çš„方法。è¿è¡ŒæœŸé—´åˆ¤æ–æ‰€å¼•ç”¨å¯¹è±¡çš„å®žé™…ç±»åž‹ï¼Œæ ¹æ®å…¶å®žé™…类型调用相应的方法。
4ã€æŠ½è±¡ã€‚把客观事物用代ç 抽象出æ¥ã€‚
## Java的基本数æ®ç±»åž‹æœ‰å“ªäº›ï¼Ÿ
- byte,8bit
- char,16bit
- short,16bit
- int,32bit
- float,32bit
- long,64bit
- double,64bit
- boolean,åªæœ‰ä¸¤ä¸ªå€¼ï¼štrueã€false,å¯ä»¥ä½¿â½¤ç”¨ 1 bit æ¥å˜å‚¨
| 简å•ç±»åž‹ | boolean | byte | char | short | Int | long | float | double |
| ---------- | ------- | ---- | --------- | ----- | ------- | ---- | ----- | ------ |
| 二进制ä½æ•° | 1 | 8 | 16 | 16 | 32 | 64 | 32 | 64 |
| 包装类 | Boolean | Byte | Character | Short | Integer | Long | Float | Double |
在Java规范ä¸ï¼Œæ²¡æœ‰æ˜Žç¡®æŒ‡å‡ºboolean的大å°ã€‚在《Java虚拟机规范》给出了å•ä¸ªbooleanå 4个å—节,和boolean数组1个å—节的定义,具体 **还è¦çœ‹è™šæ‹Ÿæœºå®žçŽ°æ˜¯å¦æŒ‰ç…§è§„范æ¥**ï¼Œå› æ¤booleanå 用1个å—节或者4个å—节都是有å¯èƒ½çš„。
## 为什么ä¸èƒ½ç”¨æµ®ç‚¹åž‹è¡¨ç¤ºé‡‘é¢ï¼Ÿ
由于计算机ä¸ä¿å˜çš„å°æ•°å…¶å®žæ˜¯å进制的å°æ•°çš„近似值,并ä¸æ˜¯å‡†ç¡®å€¼ï¼Œæ‰€ä»¥ï¼Œåƒä¸‡ä¸è¦åœ¨ä»£ç ä¸ä½¿ç”¨æµ®ç‚¹æ•°æ¥è¡¨ç¤ºé‡‘é¢ç‰é‡è¦çš„æŒ‡æ ‡ã€‚
建议使用BigDecimal或者Longæ¥è¡¨ç¤ºé‡‘é¢ã€‚
## ä»€ä¹ˆæ˜¯å€¼ä¼ é€’å’Œå¼•ç”¨ä¼ é€’ï¼Ÿ
- å€¼ä¼ é€’æ˜¯å¯¹åŸºæœ¬åž‹å˜é‡è€Œè¨€çš„ï¼Œä¼ é€’çš„æ˜¯è¯¥å˜é‡çš„一个副本,改å˜å‰¯æœ¬ä¸å½±å“原å˜é‡ã€‚
- å¼•ç”¨ä¼ é€’ä¸€èˆ¬æ˜¯å¯¹äºŽå¯¹è±¡åž‹å˜é‡è€Œè¨€çš„ï¼Œä¼ é€’çš„æ˜¯è¯¥å¯¹è±¡åœ°å€çš„一个副本,并ä¸æ˜¯åŽŸå¯¹è±¡æœ¬èº«ï¼Œä¸¤è€…指å‘åŒä¸€ç‰‡å†…å˜ç©ºé—´ã€‚所以对引用对象进行æ“作会åŒæ—¶æ”¹å˜åŽŸå¯¹è±¡ã€‚
**javaä¸ä¸å˜åœ¨å¼•ç”¨ä¼ 递,åªæœ‰å€¼ä¼ 递**。å³ä¸å˜åœ¨å˜é‡a指å‘å˜é‡b,å˜é‡b指å‘对象的这ç§æƒ…况。
## 了解Java的包装类型å—?为什么需è¦åŒ…装类?
Java 是一ç§é¢å‘对象è¯è¨€ï¼Œå¾ˆå¤šåœ°æ–¹éƒ½éœ€è¦ä½¿ç”¨å¯¹è±¡è€Œä¸æ˜¯åŸºæœ¬æ•°æ®ç±»åž‹ã€‚比如,在集åˆç±»ä¸ï¼Œæˆ‘ä»¬æ˜¯æ— æ³•å°† int ã€double ç‰ç±»åž‹æ”¾è¿›åŽ»çš„ã€‚å› ä¸ºé›†åˆçš„容器è¦æ±‚å…ƒç´ æ˜¯ Object 类型。
为了让基本类型也具有对象的特å¾ï¼Œå°±å‡ºçŽ°äº†åŒ…装类型。相当于将基本类型包装起æ¥ï¼Œä½¿å¾—å®ƒå…·æœ‰äº†å¯¹è±¡çš„æ€§è´¨ï¼Œå¹¶ä¸”ä¸ºå…¶æ·»åŠ äº†å±žæ€§å’Œæ–¹æ³•ï¼Œä¸°å¯Œäº†åŸºæœ¬ç±»åž‹çš„æ“作。
## 自动装箱和拆箱
Javaä¸åŸºç¡€æ•°æ®ç±»åž‹ä¸Žå®ƒä»¬å¯¹åº”的包装类è§ä¸‹è¡¨ï¼š
| 原始类型 | 包装类型 |
| :------- | :-------- |
| boolean | Boolean |
| byte | Byte |
| char | Character |
| float | Float |
| int | Integer |
| long | Long |
| short | Short |
| double | Double |
装箱:将基础类型转化为包装类型。
拆箱:将包装类型转化为基础类型。
å½“åŸºç¡€ç±»åž‹ä¸Žå®ƒä»¬çš„åŒ…è£…ç±»æœ‰å¦‚ä¸‹å‡ ç§æƒ…况时,编译器会**自动**帮我们进行装箱或拆箱:
- 赋值æ“作(装箱或拆箱)
- è¿›è¡ŒåŠ å‡ä¹˜é™¤æ··åˆè¿ç®— (拆箱)
- 进行>,<,==比较è¿ç®—(拆箱)
- 调用equals进行比较(装箱)
- ArrayListã€HashMapç‰é›†åˆç±»æ·»åŠ 基础类型数æ®æ—¶ï¼ˆè£…箱)
示例代ç :
```java
Integer x = 1; // 装箱 调⽤ Integer.valueOf(1)
int y = x; // 拆箱 调⽤了 X.intValue()
```
下é¢çœ‹ä¸€é“常è§çš„é¢è¯•é¢˜ï¼š
```java
Integer a = 100;
Integer b = 100;
System.out.println(a == b);
Integer c = 200;
Integer d = 200;
System.out.println(c == d);
```
输出:
```java
true
false
```
为什么第三个输出是false?看看 Integer 类的æºç 就知é“啦。
```java
public static Integer valueOf(int i) {
if (i >= IntegerCache.low && i <= IntegerCache.high)
return IntegerCache.cache[i + (-IntegerCache.low)];
return new Integer(i);
}
```
`Integer c = 200;` 会调用 调⽤`Integer.valueOf(200)`。而从Integerçš„valueOf()æºç å¯ä»¥çœ‹åˆ°ï¼Œè¿™é‡Œçš„实现并ä¸æ˜¯ç®€å•çš„new Integer,而是用IntegerCacheåšä¸€ä¸ªcache。
```java
private static class IntegerCache {
static final int low = -128;
static final int high;
static final Integer cache[];
static {
// high value may be configured by property
int h = 127;
String integerCacheHighPropValue =
sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
if (integerCacheHighPropValue != null) {
try {
int i = parseInt(integerCacheHighPropValue);
i = Math.max(i, 127);
// Maximum array size is Integer.MAX_VALUE
h = Math.min(i, Integer.MAX_VALUE - (-low) -1);
} catch( NumberFormatException nfe) {
// If the property cannot be parsed into an int, ignore it.
}
}
high = h;
}
...
}
```
这是IntegerCacheé™æ€ä»£ç å—ä¸çš„一段,默认Integer cache 的下é™æ˜¯-128,上é™é»˜è®¤127。当赋值100ç»™Integer时,刚好在这个范围内,所以从cacheä¸å–对应的Integer并返回,所以aå’Œb返回的是åŒä¸€ä¸ªå¯¹è±¡ï¼Œæ‰€ä»¥==比较是相ç‰çš„,当赋值200ç»™Integer时,ä¸åœ¨cache 的范围内,所以会new Integer并返回,当然==比较的结果是ä¸ç›¸ç‰çš„。
## String 为什么ä¸å¯å˜ï¼Ÿ
先看看什么是ä¸å¯å˜çš„对象。
如果一个对象,在它创建完æˆä¹‹åŽï¼Œä¸èƒ½å†æ”¹å˜å®ƒçš„状æ€ï¼Œé‚£ä¹ˆè¿™ä¸ªå¯¹è±¡å°±æ˜¯ä¸å¯å˜çš„。ä¸èƒ½æ”¹å˜çŠ¶æ€çš„æ„æ€æ˜¯ï¼Œä¸èƒ½æ”¹å˜å¯¹è±¡å†…çš„æˆå‘˜å˜é‡ï¼ŒåŒ…括基本数æ®ç±»åž‹çš„值ä¸èƒ½æ”¹å˜ï¼Œå¼•ç”¨ç±»åž‹çš„å˜é‡ä¸èƒ½æŒ‡å‘其他的对象,引用类型指å‘的对象的状æ€ä¹Ÿä¸èƒ½æ”¹å˜ã€‚
接ç€æ¥çœ‹Java8 String类的æºç :
```java
public final class String
implements java.io.Serializable, Comparable, CharSequence {
/** The value is used for character storage. */
private final char value[];
/** Cache the hash code for the string */
private int hash; // Default to 0
}
```
从æºç å¯ä»¥çœ‹å‡ºï¼ŒString对象其实在内部就是一个个å—符,å˜å‚¨åœ¨è¿™ä¸ªvalue数组里é¢çš„。
value数组用final修饰,final 修饰的å˜é‡ï¼Œå€¼ä¸èƒ½è¢«ä¿®æ”¹ã€‚å› æ¤valueä¸å¯ä»¥æŒ‡å‘其他对象。
String类内部所有的å—段都是ç§æœ‰çš„,也就是被private修饰。而且String没有对外æ供修改内部状æ€çš„æ–¹æ³•ï¼Œå› æ¤value数组ä¸èƒ½æ”¹å˜ã€‚
所以,String是ä¸å¯å˜çš„。
那为什么Stringè¦è®¾è®¡æˆä¸å¯å˜çš„?
主è¦æœ‰ä»¥ä¸‹å‡ ç‚¹åŽŸå› ï¼š
1. **线程安全**。åŒä¸€ä¸ªå—符串实例å¯ä»¥è¢«å¤šä¸ªçº¿ç¨‹å…±äº«ï¼Œå› 为å—符串ä¸å¯å˜ï¼Œæœ¬èº«å°±æ˜¯çº¿ç¨‹å®‰å…¨çš„。
2. **支æŒhashæ˜ å°„å’Œç¼“å˜ã€‚**å› ä¸ºStringçš„hash值ç»å¸¸ä¼šä½¿ç”¨åˆ°ï¼Œæ¯”如作为 Map 的键,ä¸å¯å˜çš„特性使得 hash 值也ä¸ä¼šå˜ï¼Œä¸éœ€è¦é‡æ–°è®¡ç®—。
3. **出于安全考虑**。网络地å€URLã€æ–‡ä»¶è·¯å¾„pathã€å¯†ç 通常情况下都是以String类型ä¿å˜ï¼Œå‡è‹¥Stringä¸æ˜¯å›ºå®šä¸å˜çš„,将会引起å„ç§å®‰å…¨éšæ‚£ã€‚比如将密ç 用String的类型ä¿å˜ï¼Œé‚£ä¹ˆå®ƒå°†ä¸€ç›´ç•™åœ¨å†…å˜ä¸ï¼Œç›´åˆ°åžƒåœ¾æ”¶é›†å™¨æŠŠå®ƒæ¸…除。å‡å¦‚Stringç±»ä¸æ˜¯å›ºå®šä¸å˜çš„,那么这个密ç å¯èƒ½ä¼šè¢«æ”¹å˜ï¼Œå¯¼è‡´å‡ºçŽ°å®‰å…¨éšæ‚£ã€‚
3. **å—符串常é‡æ± 优化**。String对象创建之åŽï¼Œä¼šç¼“å˜åˆ°å—符串常é‡æ± ä¸ï¼Œä¸‹æ¬¡éœ€è¦åˆ›å»ºåŒæ ·çš„对象时,å¯ä»¥ç›´æŽ¥è¿”回缓å˜çš„引用。
既然我们的String是ä¸å¯å˜çš„,它内部还有很多substring, replace, replaceAll这些æ“作的方法。这些方法好åƒä¼šæ”¹å˜String对象?怎么解释呢?
其实ä¸æ˜¯çš„,我们æ¯æ¬¡è°ƒç”¨replaceç‰æ–¹æ³•ï¼Œå…¶å®žä¼šåœ¨å †å†…å˜ä¸åˆ›å»ºäº†ä¸€ä¸ªæ–°çš„对象。然åŽå…¶value数组引用指å‘ä¸åŒçš„对象。
## String, StringBuffer 和 StringBuilder区别
**1. å¯å˜æ€§**
- String ä¸å¯å˜
- StringBuffer å’Œ StringBuilder å¯å˜
**2. 线程安全**
- String ä¸å¯å˜ï¼Œå› æ¤æ˜¯çº¿ç¨‹å®‰å…¨çš„
- StringBuilder ä¸æ˜¯çº¿ç¨‹å®‰å…¨çš„
- StringBuffer 是线程安全的,内部使用 synchronized 进行åŒæ¥
## 什么是StringJoiner?
StringJoiner是 Java 8 新增的一个 API,它基于 StringBuilder 实现,用于实现对å—符串之间通过分隔符拼接的场景。
StringJoiner æœ‰ä¸¤ä¸ªæž„é€ æ–¹æ³•ï¼Œç¬¬ä¸€ä¸ªæž„é€ è¦æ±‚ä¾æ¬¡ä¼ 入分隔符ã€å‰ç¼€å’ŒåŽç¼€ã€‚ç¬¬äºŒä¸ªæž„é€ åˆ™åªè¦æ±‚ä¼ å…¥åˆ†éš”ç¬¦å³å¯ï¼ˆå‰ç¼€å’ŒåŽç¼€é»˜è®¤ä¸ºç©ºå—符串)。
```java
StringJoiner(CharSequence delimiter, CharSequence prefix, CharSequence suffix)
StringJoiner(CharSequence delimiter)
```
有些å—符串拼接场景,使用 StringBuffer 或 StringBuilder 则显得比较ç¹ç。
比如下é¢çš„例å:
```java
List values = Arrays.asList(1, 3, 5);
StringBuilder sb = new StringBuilder("(");
for (int i = 0; i < values.size(); i++) {
sb.append(values.get(i));
if (i != values.size() -1) {
sb.append(",");
}
}
sb.append(")");
```
而通过StringJoineræ¥å®žçŽ°æ‹¼æŽ¥Listçš„å„ä¸ªå…ƒç´ ï¼Œä»£ç 看起æ¥æ›´åŠ 简æ´ã€‚
```java
List values = Arrays.asList(1, 3, 5);
StringJoiner sj = new StringJoiner(",", "(", ")");
for (Integer value : values) {
sj.add(value.toString());
}
```
å¦å¤–,åƒå¹³æ—¶ç»å¸¸ä½¿ç”¨çš„Collectors.joining(","),底层就是通过StringJoiner实现的。
æºç 如下:
```java
public static Collector joining(
CharSequence delimiter,CharSequence prefix,CharSequence suffix) {
return new CollectorImpl<>(
() -> new StringJoiner(delimiter, prefix, suffix),
StringJoiner::add, StringJoiner::merge,
StringJoiner::toString, CH_NOID);
}
```
## String 类的常用方法有哪些?
- indexOf():返回指定å—符的索引。
- charAt():返回指定索引处的å—符。
- replace():å—符串替æ¢ã€‚
- trim():去除å—符串两端空白。
- split():分割å—符串,返回一个分割åŽçš„å—符串数组。
- getBytes():返回å—符串的 byte 类型数组。
- length():返回å—符串长度。
- toLowerCase():将å—符串转æˆå°å†™å—æ¯ã€‚
- toUpperCase():将å—符串转æˆå¤§å†™å—符。
- substring():截å–å—符串。
- equals():å—符串比较。
## new String("dabin")ä¼šåˆ›å»ºå‡ ä¸ªå¯¹è±¡ï¼Ÿ
使用这ç§æ–¹å¼ä¼šåˆ›å»ºä¸¤ä¸ªå—符串对象(å‰æ是å—符串常é‡æ± ä¸æ²¡æœ‰ "dabin" 这个å—符串对象)。
- "dabin" 属于å—符串å—é¢é‡ï¼Œå› æ¤ç¼–译时期会在å—符串常é‡æ± ä¸åˆ›å»ºä¸€ä¸ªå—符串对象,指å‘这个 "dabin" å—符串å—é¢é‡ï¼›
- 使用 new çš„æ–¹å¼ä¼šåœ¨å †ä¸åˆ›å»ºä¸€ä¸ªå—符串对象。
## 什么是å—符串常é‡æ± ?
å—符串常é‡æ± (String Pool)ä¿å˜ç€æ‰€æœ‰å—符串å—é¢é‡ï¼Œè¿™äº›å—é¢é‡åœ¨ç¼–译时期就确定。å—符串常é‡æ± ä½äºŽå †å†…å˜ä¸ï¼Œä¸“门用æ¥å˜å‚¨å—符串常é‡ã€‚在创建å—符串时,JVM首先会检查å—符串常é‡æ± ,如果该å—符串已ç»å˜åœ¨æ± ä¸ï¼Œåˆ™è¿”回其引用,如果ä¸å˜åœ¨ï¼Œåˆ™åˆ›å»ºæ¤å—ç¬¦ä¸²å¹¶æ”¾å…¥æ± ä¸ï¼Œå¹¶è¿”回其引用。
## Object常用方法有哪些?
Javaé¢è¯•ç»å¸¸ä¼šå‡ºçŽ°çš„一é“题目,Object的常用方法。下é¢ç»™å¤§å®¶æ•´ç†ä¸€ä¸‹ã€‚
Object常用方法有:`toString()`ã€`equals()`ã€`hashCode()`ã€`clone()`ç‰ã€‚
**toString**
默认输出对象地å€ã€‚
```java
public class Person {
private int age;
private String name;
public Person(int age, String name) {
this.age = age;
this.name = name;
}
public static void main(String[] args) {
System.out.println(new Person(18, "程åºå‘˜å¤§å½¬").toString());
}
//output
//me.tyson.java.core.Person@4554617c
}
```
å¯ä»¥é‡å†™toString方法,按照é‡å†™é€»è¾‘输出对象值。
```java
public class Person {
private int age;
private String name;
public Person(int age, String name) {
this.age = age;
this.name = name;
}
@Override
public String toString() {
return name + ":" + age;
}
public static void main(String[] args) {
System.out.println(new Person(18, "程åºå‘˜å¤§å½¬").toString());
}
//output
//程åºå‘˜å¤§å½¬:18
}
```
**equals**
默认比较两个引用å˜é‡æ˜¯å¦æŒ‡å‘åŒä¸€ä¸ªå¯¹è±¡ï¼ˆå†…å˜åœ°å€ï¼‰ã€‚
```java
public class Person {
private int age;
private String name;
public Person(int age, String name) {
this.age = age;
this.name = name;
}
public static void main(String[] args) {
String name = "程åºå‘˜å¤§å½¬";
Person p1 = new Person(18, name);
Person p2 = new Person(18, name);
System.out.println(p1.equals(p2));
}
//output
//false
}
```
å¯ä»¥é‡å†™equals方法,按照ageå’Œname是å¦ç›¸ç‰æ¥åˆ¤æ–:
```java
public class Person {
private int age;
private String name;
public Person(int age, String name) {
this.age = age;
this.name = name;
}
@Override
public boolean equals(Object o) {
if (o instanceof Person) {
Person p = (Person) o;
return age == p.age && name.equals(p.name);
}
return false;
}
public static void main(String[] args) {
String name = "程åºå‘˜å¤§å½¬";
Person p1 = new Person(18, name);
Person p2 = new Person(18, name);
System.out.println(p1.equals(p2));
}
//output
//true
}
```
**hashCode**
将与对象相关的信æ¯æ˜ å°„æˆä¸€ä¸ªå“ˆå¸Œå€¼ï¼Œé»˜è®¤çš„实现hashCodeå€¼æ˜¯æ ¹æ®å†…å˜åœ°å€æ¢ç®—出æ¥ã€‚
```java
public class Cat {
public static void main(String[] args) {
System.out.println(new Cat().hashCode());
}
//out
//1349277854
}
```
**clone**
Java赋值是å¤åˆ¶å¯¹è±¡å¼•ç”¨ï¼Œå¦‚果我们想è¦å¾—到一个对象的副本,使用赋值æ“ä½œæ˜¯æ— æ³•è¾¾åˆ°ç›®çš„çš„ã€‚Object对象有个clone()方法,实现了对
象ä¸å„个属性的å¤åˆ¶ï¼Œä½†å®ƒçš„å¯è§èŒƒå›´æ˜¯protected的。
```java
protected native Object clone() throws CloneNotSupportedException;
```
所以实体类使用克隆的å‰æ是:
- 实现Cloneable接å£ï¼Œè¿™æ˜¯ä¸€ä¸ªæ ‡è®°æŽ¥å£ï¼Œè‡ªèº«æ²¡æœ‰æ–¹æ³•ï¼Œè¿™åº”该是一ç§çº¦å®šã€‚调用clone方法时,会判æ–有没有实现Cloneable接å£ï¼Œæ²¡æœ‰å®žçŽ°Cloneableçš„è¯ä¼šæŠ›å¼‚常CloneNotSupportedException。
- 覆盖clone()方法,å¯è§æ€§æå‡ä¸ºpublic。
```java
public class Cat implements Cloneable {
private String name;
@Override
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
public static void main(String[] args) throws CloneNotSupportedException {
Cat c = new Cat();
c.name = "程åºå‘˜å¤§å½¬";
Cat cloneCat = (Cat) c.clone();
c.name = "大彬";
System.out.println(cloneCat.name);
}
//output
//程åºå‘˜å¤§å½¬
}
```
**getClass**
è¿”å›žæ¤ Object çš„è¿è¡Œæ—¶ç±»ï¼Œå¸¸ç”¨äºŽjavaå射机制。
```java
public class Person {
private String name;
public Person(String name) {
this.name = name;
}
public static void main(String[] args) {
Person p = new Person("程åºå‘˜å¤§å½¬");
Class clz = p.getClass();
System.out.println(clz);
//获å–ç±»å
System.out.println(clz.getName());
}
/**
* class com.tyson.basic.Person
* com.tyson.basic.Person
*/
}
```
**wait**
当å‰çº¿ç¨‹è°ƒç”¨å¯¹è±¡çš„wait()方法之åŽï¼Œå½“å‰çº¿ç¨‹ä¼šé‡Šæ”¾å¯¹è±¡é”,进入ç‰å¾…状æ€ã€‚ç‰å¾…其他线程调用æ¤å¯¹è±¡çš„notify()/notifyAll()唤醒或者ç‰å¾…超时时间wait(long timeout)自动唤醒。线程需è¦èŽ·å–obj对象é”之åŽæ‰èƒ½è°ƒç”¨ obj.wait()。
**notify**
obj.notify()唤醒在æ¤å¯¹è±¡ä¸Šç‰å¾…çš„å•ä¸ªçº¿ç¨‹ï¼Œé€‰æ‹©æ˜¯ä»»æ„性的。notifyAll()唤醒在æ¤å¯¹è±¡ä¸Šç‰å¾…的所有线程。
## 讲讲深拷è´å’Œæµ…æ‹·è´ï¼Ÿ
**æµ…æ‹·è´**:拷⻉对象和原始对象的引⽤类型引用åŒâ¼€ä¸ªå¯¹è±¡ã€‚
以下例å,Cat对象里é¢æœ‰ä¸ªPerson对象,调用clone之åŽï¼Œå…‹éš†å¯¹è±¡å’ŒåŽŸå¯¹è±¡çš„Person引用的是åŒä¸€ä¸ªå¯¹è±¡ï¼Œè¿™å°±æ˜¯æµ…æ‹·è´ã€‚
```java
public class Cat implements Cloneable {
private String name;
private Person owner;
@Override
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
public static void main(String[] args) throws CloneNotSupportedException {
Cat c = new Cat();
Person p = new Person(18, "程åºå‘˜å¤§å½¬");
c.owner = p;
Cat cloneCat = (Cat) c.clone();
p.setName("大彬");
System.out.println(cloneCat.owner.getName());
}
//output
//大彬
}
```
**深拷è´**:拷è´å¯¹è±¡å’ŒåŽŸå§‹å¯¹è±¡çš„引用类型引用ä¸åŒçš„对象。
以下例å,在clone函数ä¸ä¸ä»…调用了super.clone,而且调用Person对象的clone方法(Person也è¦å®žçŽ°Cloneable接å£å¹¶é‡å†™clone方法),从而实现了深拷è´ã€‚å¯ä»¥çœ‹åˆ°ï¼Œæ‹·è´å¯¹è±¡çš„值ä¸ä¼šå—到原对象的影å“。
```java
public class Cat implements Cloneable {
private String name;
private Person owner;
@Override
protected Object clone() throws CloneNotSupportedException {
Cat c = null;
c = (Cat) super.clone();
c.owner = (Person) owner.clone();//æ‹·è´Person对象
return c;
}
public static void main(String[] args) throws CloneNotSupportedException {
Cat c = new Cat();
Person p = new Person(18, "程åºå‘˜å¤§å½¬");
c.owner = p;
Cat cloneCat = (Cat) c.clone();
p.setName("大彬");
System.out.println(cloneCat.owner.getName());
}
//output
//程åºå‘˜å¤§å½¬
}
```
## 两个对象的hashCode()相åŒï¼Œåˆ™ equals()是å¦ä¹Ÿä¸€å®šä¸º true?
equals与hashcode的关系:
1. 如果两个对象调用equals比较返回true,那么它们的hashCode值一定è¦ç›¸åŒï¼›
2. 如果两个对象的hashCode相åŒï¼Œå®ƒä»¬å¹¶ä¸ä¸€å®šç›¸åŒã€‚
hashcode方法主è¦æ˜¯ç”¨æ¥**æå‡å¯¹è±¡æ¯”较的效率**,先进行hashcode()的比较,如果ä¸ç›¸åŒï¼Œé‚£å°±ä¸å¿…在进行equalsçš„æ¯”è¾ƒï¼Œè¿™æ ·å°±å¤§å¤§å‡å°‘了equals比较的次数,当比较对象的数é‡å¾ˆå¤§çš„时候能æå‡æ•ˆçŽ‡ã€‚
之所以é‡å†™`equals()`è¦é‡å†™`hashcode()`,是为了ä¿è¯`equals()`方法返回true的情况下hashcode值也è¦ä¸€è‡´ï¼Œå¦‚æžœé‡å†™äº†`equals()`没有é‡å†™`hashcode()`,就会出现两个对象相ç‰ä½†`hashcode()`ä¸ç›¸ç‰çš„æƒ…å†µã€‚è¿™æ ·ï¼Œå½“ç”¨å…¶ä¸çš„一个对象作为键ä¿å˜åˆ°hashMapã€hashTable或hashSetä¸ï¼Œå†ä»¥å¦ä¸€ä¸ªå¯¹è±¡ä½œä¸ºé”®å€¼åŽ»æŸ¥æ‰¾ä»–们的时候,则会查找ä¸åˆ°ã€‚
## Javaåˆ›å»ºå¯¹è±¡æœ‰å‡ ç§æ–¹å¼ï¼Ÿ
Javaåˆ›å»ºå¯¹è±¡æœ‰ä»¥ä¸‹å‡ ç§æ–¹å¼ï¼š
- 用newè¯å¥åˆ›å»ºå¯¹è±¡ã€‚
- 使用å射,使用Class.newInstance()创建对象。
- 调用对象的clone()方法。
- è¿ç”¨ååºåˆ—化手段,调用java.io.ObjectInputStream对象的readObject()方法。
## 说说类实例化的顺åº
Javaä¸ç±»å®žä¾‹åŒ–顺åºï¼š
1. é™æ€å±žæ€§ï¼Œé™æ€ä»£ç å—。
2. 普通属性,普通代ç å—。
3. æž„é€ æ–¹æ³•ã€‚
```java
public class LifeCycle {
// é™æ€å±žæ€§
private static String staticField = getStaticField();
// é™æ€ä»£ç å—
static {
System.out.println(staticField);
System.out.println("é™æ€ä»£ç å—åˆå§‹åŒ–");
}
// 普通属性
private String field = getField();
// 普通代ç å—
{
System.out.println(field);
System.out.println("普通代ç å—åˆå§‹åŒ–");
}
// æž„é€ æ–¹æ³•
public LifeCycle() {
System.out.println("æž„é€ æ–¹æ³•åˆå§‹åŒ–");
}
// é™æ€æ–¹æ³•
public static String getStaticField() {
String statiFiled = "é™æ€å±žæ€§åˆå§‹åŒ–";
return statiFiled;
}
// 普通方法
public String getField() {
String filed = "普通属性åˆå§‹åŒ–";
return filed;
}
public static void main(String[] argc) {
new LifeCycle();
}
/**
* é™æ€å±žæ€§åˆå§‹åŒ–
* é™æ€ä»£ç å—åˆå§‹åŒ–
* 普通属性åˆå§‹åŒ–
* 普通代ç å—åˆå§‹åŒ–
* æž„é€ æ–¹æ³•åˆå§‹åŒ–
*/
}
```
## equals和==有什么区别?
- 对于基本数æ®ç±»åž‹ï¼Œ==比较的是他们的值。基本数æ®ç±»åž‹æ²¡æœ‰equal方法;
- 对于å¤åˆæ•°æ®ç±»åž‹ï¼Œ==比较的是它们的å˜æ”¾åœ°å€(是å¦æ˜¯åŒä¸€ä¸ªå¯¹è±¡)。`equals()`默认比较地å€å€¼ï¼Œé‡å†™çš„è¯æŒ‰ç…§é‡å†™é€»è¾‘去比较。
## 常è§çš„关键å—有哪些?
**static**
staticå¯ä»¥ç”¨æ¥ä¿®é¥°ç±»çš„æˆå‘˜æ–¹æ³•ã€ç±»çš„æˆå‘˜å˜é‡ã€‚
staticå˜é‡ä¹Ÿç§°ä½œ**é™æ€å˜é‡**,é™æ€å˜é‡å’Œéžé™æ€å˜é‡çš„区别是:é™æ€å˜é‡è¢«æ‰€æœ‰çš„对象所共享,在内å˜ä¸åªæœ‰ä¸€ä¸ªå‰¯æœ¬ï¼Œå®ƒå½“且仅当在类åˆæ¬¡åŠ 载时会被åˆå§‹åŒ–。而éžé™æ€å˜é‡æ˜¯å¯¹è±¡æ‰€æ‹¥æœ‰çš„,在创建对象的时候被åˆå§‹åŒ–,å˜åœ¨å¤šä¸ªå‰¯æœ¬ï¼Œå„个对象拥有的副本互ä¸å½±å“。
以下例å,age为éžé™æ€å˜é‡ï¼Œåˆ™p1打å°ç»“果是:`Name:zhangsan, Age:10`;若age使用static修饰,则p1打å°ç»“果是:`Name:zhangsan, Age:12`ï¼Œå› ä¸ºstaticå˜é‡åœ¨å†…å˜åªæœ‰ä¸€ä¸ªå‰¯æœ¬ã€‚
```java
public class Person {
String name;
int age;
public String toString() {
return "Name:" + name + ", Age:" + age;
}
public static void main(String[] args) {
Person p1 = new Person();
p1.name = "zhangsan";
p1.age = 10;
Person p2 = new Person();
p2.name = "lisi";
p2.age = 12;
System.out.println(p1);
System.out.println(p2);
}
/**Output
* Name:zhangsan, Age:10
* Name:lisi, Age:12
*///~
}
```
static方法一般称作**é™æ€æ–¹æ³•**。é™æ€æ–¹æ³•ä¸ä¾èµ–于任何对象就å¯ä»¥è¿›è¡Œè®¿é—®ï¼Œé€šè¿‡ç±»åå³å¯è°ƒç”¨é™æ€æ–¹æ³•ã€‚
```java
public class Utils {
public static void print(String s) {
System.out.println("hello world: " + s);
}
public static void main(String[] args) {
Utils.print("程åºå‘˜å¤§å½¬");
}
}
```
**é™æ€ä»£ç å—**åªä¼šåœ¨ç±»åŠ 载的时候执行一次。以下例å,startDateå’ŒendDateåœ¨ç±»åŠ è½½çš„æ—¶å€™è¿›è¡Œèµ‹å€¼ã€‚
```java
class Person {
private Date birthDate;
private static Date startDate, endDate;
static{
startDate = Date.valueOf("2008");
endDate = Date.valueOf("2021");
}
public Person(Date birthDate) {
this.birthDate = birthDate;
}
}
```
**é™æ€å†…部类**
**在é™æ€æ–¹æ³•é‡Œ**,使用⾮é™æ€å†…部类ä¾èµ–于外部类的实例,也就是说需è¦å…ˆåˆ›å»ºå¤–部类实例,æ‰èƒ½ç”¨è¿™ä¸ªå®žï¦µåŽ»åˆ›å»ºéžé™æ€å†…部类。⽽é™æ€å†…部类不需è¦ã€‚
```java
public class OuterClass {
class InnerClass {
}
static class StaticInnerClass {
}
public static void main(String[] args) {
// 在é™æ€æ–¹æ³•é‡Œï¼Œä¸èƒ½ç›´æŽ¥ä½¿ç”¨OuterClass.this去创建InnerClass的实例
// 需è¦å…ˆåˆ›å»ºOuterClass的实例o,然åŽé€šè¿‡o创建InnerClass的实例
// InnerClass innerClass = new InnerClass();
OuterClass outerClass = new OuterClass();
InnerClass innerClass = outerClass.new InnerClass();
StaticInnerClass staticInnerClass = new StaticInnerClass();
outerClass.test();
}
public void nonStaticMethod() {
InnerClass innerClass = new InnerClass();
System.out.println("nonStaticMethod...");
}
}
```
**final**
1. **基本数æ®**类型用final修饰,则ä¸èƒ½ä¿®æ”¹ï¼Œæ˜¯å¸¸é‡ï¼›**对象引用**用final修饰,则引用åªèƒ½æŒ‡å‘该对象,ä¸èƒ½æŒ‡å‘别的对象,但是对象本身å¯ä»¥ä¿®æ”¹ã€‚
2. final修饰的方法ä¸èƒ½è¢«åç±»é‡å†™
3. final修饰的类ä¸èƒ½è¢«ç»§æ‰¿ã€‚
**this**
`this.属性å称`指访问类ä¸çš„æˆå‘˜å˜é‡ï¼Œå¯ä»¥ç”¨æ¥åŒºåˆ†æˆå‘˜å˜é‡å’Œå±€éƒ¨å˜é‡ã€‚如下代ç 所示,`this.name`访问类Person当å‰å®žä¾‹çš„å˜é‡ã€‚
```java
/**
* @description:
* @author: 程åºå‘˜å¤§å½¬
* @time: 2021-08-17 00:29
*/
public class Person {
String name;
int age;
public Person(String name, int age) {
this.name = name;
this.age = age;
}
}
```
`this.方法å称`用æ¥è®¿é—®æœ¬ç±»çš„方法。以下代ç ä¸ï¼Œ`this.born()`调用类 Person 的当å‰å®žä¾‹çš„方法。
```java
/**
* @description:
* @author: 程åºå‘˜å¤§å½¬
* @time: 2021-08-17 00:29
*/
public class Person {
String name;
int age;
public Person(String name, int age) {
this.born();
this.name = name;
this.age = age;
}
void born() {
}
}
```
**super**
super 关键å—用于在åç±»ä¸è®¿é—®çˆ¶ç±»çš„å˜é‡å’Œæ–¹æ³•ã€‚
```java
class A {
protected String name = "大彬";
public void getName() {
System.out.println("父类:" + name);
}
}
public class B extends A {
@Override
public void getName() {
System.out.println(super.name);
super.getName();
}
public static void main(String[] args) {
B b = new B();
b.getName();
}
/**
* 大彬
* 父类:大彬
*/
}
```
在åç±»Bä¸ï¼Œæˆ‘们é‡å†™äº†çˆ¶ç±»çš„`getName()`方法,如果在é‡å†™çš„`getName()`方法ä¸æˆ‘们è¦è°ƒç”¨çˆ¶ç±»çš„相åŒæ–¹æ³•ï¼Œå¿…é¡»è¦é€šè¿‡super关键å—显å¼æŒ‡å‡ºã€‚
## final, finally, finalize 的区别
- final 用于修饰属性ã€æ–¹æ³•å’Œç±», 分别表示属性ä¸èƒ½è¢«é‡æ–°èµ‹å€¼ï¼Œæ–¹æ³•ä¸å¯è¢«è¦†ç›–,类ä¸å¯è¢«ç»§æ‰¿ã€‚
- finally 是异常处ç†è¯å¥ç»“构的一部分,一般以`try-catch-finally`出现,`finally`代ç å—表示总是被执行。
- finalize 是Object类的一个方法,该方法一般由垃圾回收器æ¥è°ƒç”¨ï¼Œå½“我们调用`System.gc()`方法的时候,由垃圾回收器调用`finalize()`方法,回收垃圾,JVM并ä¸ä¿è¯æ¤æ–¹æ³•æ€»è¢«è°ƒç”¨ã€‚
## final关键å—的作用?
- final 修饰的类ä¸èƒ½è¢«ç»§æ‰¿ã€‚
- final 修饰的方法ä¸èƒ½è¢«é‡å†™ã€‚
- final 修饰的å˜é‡å«å¸¸é‡ï¼Œå¸¸é‡å¿…é¡»åˆå§‹åŒ–,åˆå§‹åŒ–之åŽå€¼å°±ä¸èƒ½è¢«ä¿®æ”¹ã€‚
## 方法é‡è½½å’Œé‡å†™çš„区别?
**åŒä¸ªç±»ä¸çš„多个方法å¯ä»¥æœ‰ç›¸åŒçš„方法å称,但是有ä¸åŒçš„å‚数列表,这就称为方法é‡è½½ã€‚**å‚数列表åˆå«å‚æ•°ç¾å,包括å‚数的类型ã€å‚数的个数ã€å‚数的顺åºï¼Œåªè¦æœ‰ä¸€ä¸ªä¸åŒå°±å«åšå‚数列表ä¸åŒã€‚
é‡è½½æ˜¯é¢å‘对象的一个基本特性。
```java
public class OverrideTest {
void setPerson() { }
void setPerson(String name) {
//set name
}
void setPerson(String name, int age) {
//set name and age
}
}
```
**方法的é‡å†™æ述的是父类和åç±»ä¹‹é—´çš„ã€‚å½“çˆ¶ç±»çš„åŠŸèƒ½æ— æ³•æ»¡è¶³å类的需求,å¯ä»¥åœ¨å类对方法进行é‡å†™ã€‚**方法é‡å†™æ—¶ï¼Œ 方法å与形å‚列表必须一致。
如下代ç ,Person为父类,Student为å类,在Studentä¸é‡å†™äº†dailyTask方法。
```java
public class Person {
private String name;
public void dailyTask() {
System.out.println("work eat sleep");
}
}
public class Student extends Person {
@Override
public void dailyTask() {
System.out.println("study eat sleep");
}
}
```
## 接å£ä¸ŽæŠ½è±¡ç±»åŒºåˆ«ï¼Ÿ
1ã€**è¯æ³•å±‚é¢**上的区别
- 抽象类å¯ä»¥æœ‰æ–¹æ³•å®žçŽ°ï¼Œè€ŒæŽ¥å£çš„方法ä¸åªèƒ½æ˜¯æŠ½è±¡æ–¹æ³•ï¼ˆJava 8 开始接å£æ–¹æ³•å¯ä»¥æœ‰é»˜è®¤å®žçŽ°ï¼‰ï¼›
- 抽象类ä¸çš„æˆå‘˜å˜é‡å¯ä»¥æ˜¯å„ç§ç±»åž‹çš„,接å£ä¸çš„æˆå‘˜å˜é‡åªèƒ½æ˜¯public static final类型;
- 接å£ä¸ä¸èƒ½å«æœ‰é™æ€ä»£ç å—以åŠé™æ€æ–¹æ³•ï¼Œè€ŒæŠ½è±¡ç±»å¯ä»¥æœ‰é™æ€ä»£ç å—å’Œé™æ€æ–¹æ³•ï¼›
- 一个类åªèƒ½ç»§æ‰¿ä¸€ä¸ªæŠ½è±¡ç±»ï¼Œè€Œä¸€ä¸ªç±»å´å¯ä»¥å®žçŽ°å¤šä¸ªæŽ¥å£ã€‚
2ã€**设计层é¢**上的区别
- 抽象层次ä¸åŒã€‚抽象类是对整个类整体进行抽象,包括属性ã€è¡Œä¸ºï¼Œä½†æ˜¯æŽ¥å£åªæ˜¯å¯¹ç±»è¡Œä¸ºè¿›è¡ŒæŠ½è±¡ã€‚继承抽象类是一ç§"是ä¸æ˜¯"的关系,而接å£å®žçŽ°åˆ™æ˜¯ "有没有"的关系。如果一个类继承了æŸä¸ªæŠ½è±¡ç±»ï¼Œåˆ™å类必定是抽象类的ç§ç±»ï¼Œè€ŒæŽ¥å£å®žçŽ°åˆ™æ˜¯å…·å¤‡ä¸å…·å¤‡çš„关系,比如鸟是å¦èƒ½é£žã€‚
- 继承抽象类的是具有相似特点的类,而实现接å£çš„å´å¯ä»¥ä¸åŒçš„类。
门和è¦æŠ¥çš„例å:
```java
class AlarmDoor extends Door implements Alarm {
//code
}
class BMWCar extends Car implements Alarm {
//code
}
```
## 常è§çš„Exception有哪些?
常è§çš„RuntimeException:
1. `ClassCastException` //类型转æ¢å¼‚常
2. `IndexOutOfBoundsException` //数组越界异常
3. `NullPointerException` //空指针
4. `ArrayStoreException` //数组å˜å‚¨å¼‚常
5. `NumberFormatException` //æ•°å—æ ¼å¼åŒ–异常
6. `ArithmeticException` //æ•°å¦è¿ç®—异常
unchecked Exception:
1. `NoSuchFieldException` //å射异常,没有对应的å—段
2. `ClassNotFoundException` //类没有找到异常
3. `IllegalAccessException` //安全æƒé™å¼‚常,å¯èƒ½æ˜¯å射时调用了private方法
## Error和Exception的区别?
**Error**:JVM æ— æ³•è§£å†³çš„ä¸¥é‡é—®é¢˜ï¼Œå¦‚æ ˆæº¢å‡º`StackOverflowError`ã€å†…å˜æº¢å‡º`OOM`ç‰ã€‚程åºæ— 法处ç†çš„错误。
**Exception**ï¼šå…¶å®ƒå› ç¼–ç¨‹é”™è¯¯æˆ–å¶ç„¶çš„å¤–åœ¨å› ç´ å¯¼è‡´çš„ä¸€èˆ¬æ€§é—®é¢˜ã€‚å¯ä»¥åœ¨ä»£ç ä¸è¿›è¡Œå¤„ç†ã€‚如:空指针异常ã€æ•°ç»„ä¸‹æ ‡è¶Šç•Œç‰ã€‚
## è¿è¡Œæ—¶å¼‚常和éžè¿è¡Œæ—¶å¼‚常(checked)的区别?
`unchecked exception`包括`RuntimeException`和`Error`类,其他所有异常称为检查(checked)异常。
1. `RuntimeException`由程åºé”™è¯¯å¯¼è‡´ï¼Œåº”该修æ£ç¨‹åºé¿å…这类异常å‘生。
2. `checked Exception`由具体的环境(读å–的文件ä¸å˜åœ¨æˆ–文件为空或sql异常)导致的异常。必须进行处ç†ï¼Œä¸ç„¶ç¼–译ä¸é€šè¿‡ï¼Œå¯ä»¥catch或者throws。
## throw和throws的区别?
- **throw**:用于抛出一个具体的异常对象。
- **throws**:用在方法ç¾åä¸ï¼Œç”¨äºŽå£°æ˜Žè¯¥æ–¹æ³•å¯èƒ½æŠ›å‡ºçš„异常。åç±»æ–¹æ³•æŠ›å‡ºçš„å¼‚å¸¸èŒƒå›´æ›´åŠ å°ï¼Œæˆ–è€…æ ¹æœ¬ä¸æŠ›å¼‚常。
## 通过故事讲清楚NIO
下é¢é€šè¿‡ä¸€ä¸ªä¾‹åæ¥è®²è§£ä¸‹ã€‚
å‡è®¾æŸé“¶è¡Œåªæœ‰10个èŒå‘˜ã€‚该银行的业务æµç¨‹åˆ†ä¸ºä»¥ä¸‹4个æ¥éª¤ï¼š
1) 顾客填申请表(5分钟);
2) èŒå‘˜å®¡æ ¸ï¼ˆ1分钟);
3) èŒå‘˜å«ä¿å®‰åŽ»é‡‘库å–钱(3分钟);
4) èŒå‘˜æ‰“å°ç¥¨æ®ï¼Œå¹¶å°†é’±å’Œç¥¨æ®è¿”回给顾客(1分钟)。
下é¢æˆ‘们看看银行ä¸åŒçš„工作方å¼å¯¹å…¶å·¥ä½œæ•ˆçŽ‡åˆ°åº•æœ‰ä½•å½±å“。
首先是BIOæ–¹å¼ã€‚
æ¯æ¥ä¸€ä¸ªé¡¾å®¢ï¼Œé©¬ä¸Šç”±ä¸€ä½èŒå‘˜æ¥æŽ¥å¾…处ç†ï¼Œå¹¶ä¸”这个èŒå‘˜éœ€è¦è´Ÿè´£ä»¥ä¸Š4个完整æµç¨‹ã€‚当超过10个顾客时,剩余的顾客需è¦æŽ’队ç‰å€™ã€‚
一个èŒå‘˜å¤„ç†ä¸€ä¸ªé¡¾å®¢éœ€è¦10分钟(5+1+3+1)时间。一个å°æ—¶ï¼ˆ60分钟)能处ç†6个顾客,一共10个èŒå‘˜ï¼Œé‚£å°±æ˜¯åªèƒ½å¤„ç†60个顾客。
å¯ä»¥çœ‹åˆ°é“¶è¡ŒèŒå‘˜çš„工作状æ€å¹¶ä¸é¥±å’Œï¼Œæ¯”如在第1æ¥ï¼Œå…¶å®žæ˜¯å¤„于ç‰å¾…ä¸ã€‚
è¿™ç§å·¥ä½œå…¶å®žå°±æ˜¯BIO,æ¯æ¬¡æ¥ä¸€ä¸ªè¯·æ±‚(顾客),就分é…åˆ°çº¿ç¨‹æ± ä¸ç”±ä¸€ä¸ªçº¿ç¨‹ï¼ˆèŒå‘˜ï¼‰å¤„ç†ï¼Œå¦‚æžœè¶…å‡ºäº†çº¿ç¨‹æ± çš„æœ€å¤§ä¸Šé™ï¼ˆ10个),就扔到队列ç‰å¾… 。
那么如何æ高银行的åžåé‡å‘¢ï¼Ÿ
æ€è·¯å°±æ˜¯ï¼š**分而治之**,将任务拆分开æ¥ï¼Œç”±ä¸“门的人负责专门的任务。
具体æ¥è®²ï¼Œé“¶è¡Œä¸“门指派一åèŒå‘˜A,A的工作就是æ¯å½“æœ‰é¡¾å®¢åˆ°é“¶è¡Œï¼Œä»–å°±é€’ä¸Šè¡¨æ ¼è®©é¡¾å®¢å¡«å†™ã€‚æ¯å½“有顾客填好表åŽï¼ŒA就将其éšæœºæŒ‡æ´¾ç»™å‰©ä½™çš„9åèŒå‘˜å®ŒæˆåŽç»æ¥éª¤ã€‚
è¿™ç§æ–¹å¼ä¸‹ï¼Œå‡è®¾é¡¾å®¢éžå¸¸å¤šï¼ŒèŒå‘˜A的工作处于饱和ä¸ï¼Œä»–ä¸æ–的将填好表的顾客带到柜å°å¤„ç†ã€‚
柜å°ä¸€ä¸ªèŒå‘˜5分钟能处ç†å®Œä¸€ä¸ªé¡¾å®¢ï¼Œä¸€ä¸ªå°æ—¶9åèŒå‘˜èƒ½å¤„ç†ï¼š9*(60/5)=108。
å¯è§å·¥ä½œæ–¹å¼çš„转å˜èƒ½å¸¦æ¥æ•ˆçŽ‡çš„æžå¤§æå‡ã€‚
è¿™ç§å·¥ä½œæ–¹å¼å…¶å®žå°±NIOçš„æ€è·¯ã€‚
下图是éžå¸¸ç»å…¸çš„NIO说明图,`mainReactor`线程负责监å¬server socket,接收新连接,并将建立的socket分派给`subReactor`
`subReactor`å¯ä»¥æ˜¯ä¸€ä¸ªçº¿ç¨‹ï¼Œä¹Ÿå¯ä»¥æ˜¯çº¿ç¨‹æ± ,负责多路分离已连接的socket,读写网络数æ®ã€‚这里的读写网络数æ®å¯ç±»æ¯”顾客填表这一耗时动作,对具体的业务处ç†åŠŸèƒ½ï¼Œå…¶æ‰”ç»™workerçº¿ç¨‹æ± å®Œæˆ
å¯ä»¥çœ‹åˆ°å…¸åž‹NIO有三类线程,分别是`mainReactor`线程ã€`subReactor`线程ã€`work`线程。
ä¸åŒçš„线程干专业的事情,最终æ¯ä¸ªçº¿ç¨‹éƒ½æ²¡ç©ºç€ï¼Œç³»ç»Ÿçš„åžåé‡è‡ªç„¶å°±ä¸ŠåŽ»äº†ã€‚

**那这个æµç¨‹è¿˜æœ‰æ²¡æœ‰ä»€ä¹ˆå¯ä»¥æ高的地方呢?**
å¯ä»¥çœ‹åˆ°ï¼Œåœ¨è¿™ä¸ªä¸šåŠ¡æµç¨‹é‡Œè¾¹ç¬¬3个æ¥éª¤ï¼ŒèŒå‘˜å«ä¿å®‰åŽ»é‡‘库å–钱(3分钟)。这3分钟柜å°èŒå‘˜æ˜¯åœ¨ç‰å¾…ä¸åº¦è¿‡çš„,å¯ä»¥æŠŠè¿™3分钟利用起æ¥ã€‚
还是分而治之的æ€è·¯ï¼ŒæŒ‡æ´¾1个èŒå‘˜Bæ¥ä¸“门负责第3æ¥éª¤ã€‚
æ¯å½“柜å°å‘˜å·¥å®Œæˆç¬¬2æ¥æ—¶ï¼Œå°±é€šçŸ¥èŒå‘˜Bæ¥è´Ÿè´£ä¸Žä¿å®‰æ²Ÿé€šå–钱。这时候柜å°å‘˜å·¥å¯ä»¥ç»§ç»å¤„ç†ä¸‹ä¸€ä¸ªé¡¾å®¢ã€‚
当èŒå‘˜B拿到钱之åŽï¼Œé€šçŸ¥é¡¾å®¢é’±å·²ç»åˆ°æŸœå°äº†ï¼Œè®©é¡¾å®¢é‡æ–°æŽ’队处ç†ï¼Œå½“柜å°èŒå‘˜å†æ¬¡æœåŠ¡è¯¥é¡¾å®¢æ—¶ï¼Œå‘现该顾客å‰3æ¥å·²ç»å®Œæˆï¼Œç›´æŽ¥æ‰§è¡Œç¬¬4æ¥å³å¯ã€‚
在当今webæœåŠ¡ä¸ï¼Œç»å¸¸éœ€è¦é€šè¿‡RPC或者Httpç‰æ–¹å¼è°ƒç”¨ç¬¬ä¸‰æ–¹æœåŠ¡ï¼Œè¿™é‡Œå¯¹åº”的就是第3æ¥ï¼Œå¦‚果这æ¥è€—时较长,通过异æ¥æ–¹å¼å°†èƒ½æžå¤§é™ä½Žèµ„æºä½¿ç”¨çŽ‡ã€‚
NIO+异æ¥çš„æ–¹å¼èƒ½è®©å°‘é‡çš„线程åšå¤§é‡çš„事情。这适用于很多应用场景,比如代ç†æœåŠ¡ã€apiæœåŠ¡ã€é•¿è¿žæŽ¥æœåŠ¡ç‰ç‰ã€‚这些应用如果用åŒæ¥æ–¹å¼å°†è€—费大é‡æœºå™¨èµ„æºã€‚
ä¸è¿‡è™½ç„¶NIO+异æ¥èƒ½æ高系统åžåé‡ï¼Œä½†å…¶å¹¶ä¸èƒ½è®©ä¸€ä¸ªè¯·æ±‚çš„ç‰å¾…时间下é™ï¼Œç›¸åå¯èƒ½ä¼šå¢žåŠ ç‰å¾…时间。
最åŽï¼ŒNIO基本æ€æƒ³æ€»ç»“èµ·æ¥å°±æ˜¯ï¼š**分而治之,将任务拆分开æ¥ï¼Œç”±ä¸“门的人负责专门的任务**
## BIO/NIO/AIO区别的区别?
**åŒæ¥é˜»å¡žIO** : 用户进程å‘起一个IOæ“作以åŽï¼Œå¿…é¡»ç‰å¾…IOæ“作的真æ£å®ŒæˆåŽï¼Œæ‰èƒ½ç»§ç»è¿è¡Œã€‚
**åŒæ¥éžé˜»å¡žIO**: 客户端与æœåŠ¡å™¨é€šè¿‡Channel连接,采用多路å¤ç”¨å™¨è½®è¯¢æ³¨å†Œçš„`Channel`。æ高åžåé‡å’Œå¯é 性。用户进程å‘起一个IOæ“作以åŽï¼Œå¯åšå…¶å®ƒäº‹æƒ…,但用户进程需è¦è½®è¯¢IOæ“作是å¦å®Œæˆï¼Œè¿™æ ·é€ æˆä¸å¿…è¦çš„CPU资æºæµªè´¹ã€‚
**异æ¥éžé˜»å¡žIO**: éžé˜»å¡žå¼‚æ¥é€šä¿¡æ¨¡å¼ï¼ŒNIOçš„å‡çº§ç‰ˆï¼Œé‡‡ç”¨å¼‚æ¥é€šé“实现异æ¥é€šä¿¡ï¼Œå…¶readå’Œwrite方法å‡æ˜¯å¼‚æ¥æ–¹æ³•ã€‚用户进程å‘起一个IOæ“作,然åŽç«‹å³è¿”回,ç‰IOæ“作真æ£çš„完æˆä»¥åŽï¼Œåº”用程åºä¼šå¾—到IOæ“作完æˆçš„通知。类似Future模å¼ã€‚
## 守护线程是什么?
- 守护线程是è¿è¡Œåœ¨åŽå°çš„一ç§ç‰¹æ®Šè¿›ç¨‹ã€‚
- 它独立于控制终端并且周期性地执行æŸç§ä»»åŠ¡æˆ–ç‰å¾…处ç†æŸäº›å‘生的事件。
- 在 Java ä¸åžƒåœ¾å›žæ”¶çº¿ç¨‹å°±æ˜¯ç‰¹æ®Šçš„守护线程。
## Java支æŒå¤šç»§æ‰¿å—?
javaä¸ï¼Œ**ç±»ä¸æ”¯æŒ**多继承。**接å£æ‰æ”¯æŒ**多继承。接å£çš„作用是拓展对象功能。当一个å接å£ç»§æ‰¿äº†å¤šä¸ªçˆ¶æŽ¥å£æ—¶ï¼Œè¯´æ˜Žå接å£æ‹“展了多个功能。当一个类实现该接å£æ—¶ï¼Œå°±æ‹“展了多个的功能。
Javaä¸æ”¯æŒå¤šç»§æ‰¿çš„åŽŸå› ï¼š
- 出于安全性的考虑,如果å类继承的多个父类里é¢æœ‰ç›¸åŒçš„方法或者属性,å类将ä¸çŸ¥é“具体è¦ç»§æ‰¿å“ªä¸ªã€‚
- Javaæ供了接å£å’Œå†…部类以达到实现多继承功能,弥补å•ç»§æ‰¿çš„缺陷。
## 如何实现对象克隆?
- 实现`Cloneable`接å£ï¼Œé‡å†™ `clone()` 方法。这ç§æ–¹å¼æ˜¯æµ…æ‹·è´ï¼Œå³å¦‚果类ä¸å±žæ€§æœ‰è‡ªå®šä¹‰å¼•ç”¨ç±»åž‹ï¼Œåªæ‹·è´å¼•ç”¨ï¼Œä¸æ‹·è´å¼•ç”¨æŒ‡å‘的对象。如果对象的属性的Class也实现 `Cloneable` 接å£ï¼Œé‚£ä¹ˆåœ¨å…‹éš†å¯¹è±¡æ—¶ä¹Ÿä¼šå…‹éš†å±žæ€§ï¼Œå³æ·±æ‹·è´ã€‚
- 结åˆåºåˆ—化,深拷è´ã€‚
- 通过`org.apache.commons`ä¸çš„工具类`BeanUtils`å’Œ`PropertyUtils`进行对象å¤åˆ¶ã€‚
## åŒæ¥å’Œå¼‚æ¥çš„区别?
åŒæ¥ï¼šå‘出一个调用时,在没有得到结果之å‰ï¼Œè¯¥è°ƒç”¨å°±ä¸è¿”回。
异æ¥ï¼šåœ¨è°ƒç”¨å‘出åŽï¼Œè¢«è°ƒç”¨è€…返回结果之åŽä¼šé€šçŸ¥è°ƒç”¨è€…,或通过回调函数处ç†è¿™ä¸ªè°ƒç”¨ã€‚
## 阻塞和éžé˜»å¡žçš„区别?
阻塞和éžé˜»å¡žå…³æ³¨çš„是线程的状æ€ã€‚
阻塞调用是指调用结果返回之å‰ï¼Œå½“å‰çº¿ç¨‹ä¼šè¢«æŒ‚起。调用线程åªæœ‰åœ¨å¾—到结果之åŽæ‰ä¼šæ¢å¤è¿è¡Œã€‚
éžé˜»å¡žè°ƒç”¨æŒ‡åœ¨ä¸èƒ½ç«‹åˆ»å¾—到结果之å‰ï¼Œè¯¥è°ƒç”¨ä¸ä¼šé˜»å¡žå½“å‰çº¿ç¨‹ã€‚
> 举个例å,ç†è§£ä¸‹åŒæ¥ã€é˜»å¡žã€å¼‚æ¥ã€éžé˜»å¡žçš„区别:
>
> åŒæ¥å°±æ˜¯çƒ§å¼€æ°´ï¼Œè¦è‡ªå·±æ¥çœ‹å¼€æ²¡å¼€ï¼›å¼‚æ¥å°±æ˜¯æ°´å¼€äº†ï¼Œç„¶åŽæ°´å£¶å“äº†é€šçŸ¥ä½ æ°´å¼€äº†ï¼ˆå›žè°ƒé€šçŸ¥ï¼‰ã€‚é˜»å¡žæ˜¯çƒ§å¼€æ°´çš„è¿‡ç¨‹ä¸ï¼Œä½ ä¸èƒ½å¹²å…¶ä»–事情,必须在æ—è¾¹ç‰ç€ï¼›éžé˜»å¡žæ˜¯çƒ§å¼€æ°´çš„过程里å¯ä»¥å¹²å…¶ä»–事情。
## Java8的新特性有哪些?
- Lambda 表达å¼ï¼šLambdaå…许把函数作为一个方法的å‚æ•°
- Stream API ï¼šæ–°æ·»åŠ çš„Stream API(java.util.stream) 把真æ£çš„函数å¼ç¼–ç¨‹é£Žæ ¼å¼•å…¥åˆ°Javaä¸
- 默认方法:默认方法就是一个在接å£é‡Œé¢æœ‰äº†ä¸€ä¸ªå®žçŽ°çš„方法。
- Optional ç±» :Optional 类已ç»æˆä¸º Java 8 类库的一部分,用æ¥è§£å†³ç©ºæŒ‡é’ˆå¼‚常。
- Date Time API ï¼šåŠ å¼ºå¯¹æ—¥æœŸä¸Žæ—¶é—´çš„å¤„ç†ã€‚
> [Java8 新特性总结]([Java-learning/Java8.md at master · Tyson0314/Java-learning (github.com)](https://github.com/Tyson0314/Java-learning/blob/master/Java/Java8.md))
## 什么是åºåˆ—化和ååºåˆ—化?
åºåˆ—化:把内å˜ä¸çš„对象转æ¢ä¸ºå—节åºåˆ—的过程。
ååºåˆ—化:把å—节åºåˆ—æ¢å¤ä¸ºJava对象的过程。
## 如何实现åºåˆ—化
实现`Serializable`接å£å³å¯ã€‚åºåˆ—化的时候(如`objectOutputStream.writeObject(user)`),会判æ–user是å¦å®žçŽ°äº†`Serializable`,如果对象没有实现`Serializable`接å£ï¼Œåœ¨åºåˆ—化的时候会抛出`NotSerializableException`异常。æºç 如下:
```java
// remaining cases
if (obj instanceof String) {
writeString((String) obj, unshared);
} else if (cl.isArray()) {
writeArray(obj, desc, unshared);
} else if (obj instanceof Enum) {
writeEnum((Enum>) obj, desc, unshared);
} else if (obj instanceof Serializable) {
writeOrdinaryObject(obj, desc, unshared);
} else {
if (extendedDebugInfo) {
throw new NotSerializableException(
cl.getName() + "\n" + debugInfoStack.toString());
} else {
throw new NotSerializableException(cl.getName());
}
}
```
## transient关键å—的作用?
Javaè¯è¨€çš„关键å—,å˜é‡ä¿®é¥°ç¬¦ï¼Œå¦‚果用transient声明一个实例å˜é‡ï¼Œå½“对象å˜å‚¨æ—¶ï¼Œå®ƒçš„值ä¸éœ€è¦ç»´æŒã€‚
也就是说被transient修饰的æˆå‘˜å˜é‡ï¼Œåœ¨åºåˆ—化的时候其值会被忽略,在被ååºåˆ—化åŽï¼Œ transient å˜é‡çš„值被设为åˆå§‹å€¼ï¼Œ 如 int 型的是 0,对象型的是 null。
## 什么是å射?
动æ€èŽ·å–çš„ä¿¡æ¯ä»¥åŠåŠ¨æ€è°ƒç”¨å¯¹è±¡çš„方法的功能称为Javaè¯è¨€çš„å射机制。
在è¿è¡ŒçŠ¶æ€ä¸ï¼Œå¯¹äºŽä»»æ„一个类,能够知é“这个类的所有属性和方法。对于任æ„一个对象,能够调用它的任æ„一个方法和属性。
## å射有哪些应用场景呢?
1. JDBC连接数æ®åº“时使用`Class.forName()`通过åå°„åŠ è½½æ•°æ®åº“的驱动程åº
2. Eclispeã€IDEAç‰å¼€å‘工具利用å射动æ€è§£æžå¯¹è±¡çš„类型与结构,动æ€æ示对象的属性和方法
3. WebæœåŠ¡å™¨ä¸åˆ©ç”¨å射调用了Sevletçš„`service`方法
4. JDK动æ€ä»£ç†åº•å±‚ä¾èµ–å射实现
## 讲讲什么是泛型?
Java泛型是JDK 5ä¸å¼•â¼Šçš„⼀个新特性, å…许在定义类和接å£çš„时候使⽤类型å‚数。声明的类型å‚数在使⽤时⽤具体的类型æ¥æ›¿æ¢ã€‚
泛型最⼤的好处是å¯ä»¥æ⾼代ç çš„å¤â½¤æ€§ã€‚以List接å£ä¸ºä¾‹ï¼Œæˆ‘们å¯ä»¥å°†String〠Integerç‰ç±»åž‹æ”¾â¼ŠListä¸ï¼Œ 如ä¸â½¤æ³›åž‹ï¼Œ å˜æ”¾String类型è¦å†™â¼€ä¸ªList接å£ï¼Œ å˜æ”¾Integerè¦å†™å¦å¤–⼀个List接å£ï¼Œ 泛型å¯ä»¥å¾ˆå¥½çš„解决这个问题。
## String为什么ä¸å¯å˜ï¼Ÿ
先看看什么是ä¸å¯å˜çš„对象。
如果一个对象,在它创建完æˆä¹‹åŽï¼Œä¸èƒ½å†æ”¹å˜å®ƒçš„状æ€ï¼Œé‚£ä¹ˆè¿™ä¸ªå¯¹è±¡å°±æ˜¯ä¸å¯å˜çš„。
ä¸èƒ½æ”¹å˜çŠ¶æ€çš„æ„æ€æ˜¯ï¼Œä¸èƒ½æ”¹å˜å¯¹è±¡å†…çš„æˆå‘˜å˜é‡ï¼ŒåŒ…括基本数æ®ç±»åž‹çš„值ä¸èƒ½æ”¹å˜ï¼Œå¼•ç”¨ç±»åž‹çš„å˜é‡ä¸èƒ½æŒ‡å‘其他的对象,引用类型指å‘的对象的状æ€ä¹Ÿä¸èƒ½æ”¹å˜ã€‚
接ç€æ¥çœ‹Java8 String类的æºç :
```java
public final class String
implements java.io.Serializable, Comparable, CharSequence {
/ The value is used for character storage. */
private final char value[];
/ Cache the hash code for the string */
private int hash; // Default to 0
}
```
从æºç å¯ä»¥çœ‹å‡ºï¼ŒString对象其实在内部就是一个个å—符,å˜å‚¨åœ¨è¿™ä¸ªvalue数组里é¢çš„。
value数组用final修饰,final 修饰的å˜é‡ï¼Œå€¼ä¸èƒ½è¢«ä¿®æ”¹ã€‚å› æ¤valueä¸å¯ä»¥æŒ‡å‘其他对象。
String类内部所有的å—段都是ç§æœ‰çš„,也就是被private修饰。而且String没有对外æ供修改内部状æ€çš„æ–¹æ³•ï¼Œå› æ¤value数组ä¸èƒ½æ”¹å˜ã€‚
所以,String是ä¸å¯å˜çš„。
那为什么Stringè¦è®¾è®¡æˆä¸å¯å˜çš„?
主è¦æœ‰ä»¥ä¸‹å‡ ç‚¹åŽŸå› ï¼š
1. 线程安全。åŒä¸€ä¸ªå—符串实例å¯ä»¥è¢«å¤šä¸ªçº¿ç¨‹å…±äº«ï¼Œå› 为å—符串ä¸å¯å˜ï¼Œæœ¬èº«å°±æ˜¯çº¿ç¨‹å®‰å…¨çš„。
2. 支æŒhashæ˜ å°„å’Œç¼“å˜ã€‚å› ä¸ºStringçš„hash值ç»å¸¸ä¼šä½¿ç”¨åˆ°ï¼Œæ¯”如作为 Map 的键,ä¸å¯å˜çš„特性使得 hash 值也ä¸ä¼šå˜ï¼Œä¸éœ€è¦é‡æ–°è®¡ç®—。
3. 出于安全考虑。网络地å€URLã€æ–‡ä»¶è·¯å¾„pathã€å¯†ç 通常情况下都是以String类型ä¿å˜ï¼Œå‡è‹¥Stringä¸æ˜¯å›ºå®šä¸å˜çš„,将会引起å„ç§å®‰å…¨éšæ‚£ã€‚比如将密ç 用String的类型ä¿å˜ï¼Œé‚£ä¹ˆå®ƒå°†ä¸€ç›´ç•™åœ¨å†…å˜ä¸ï¼Œç›´åˆ°åžƒåœ¾æ”¶é›†å™¨æŠŠå®ƒæ¸…除。å‡å¦‚Stringç±»ä¸æ˜¯å›ºå®šä¸å˜çš„,那么这个密ç å¯èƒ½ä¼šè¢«æ”¹å˜ï¼Œå¯¼è‡´å‡ºçŽ°å®‰å…¨éšæ‚£ã€‚
4. å—符串常é‡æ± 优化。String对象创建之åŽï¼Œä¼šç¼“å˜åˆ°å—符串常é‡æ± ä¸ï¼Œä¸‹æ¬¡éœ€è¦åˆ›å»ºåŒæ ·çš„对象时,å¯ä»¥ç›´æŽ¥è¿”回缓å˜çš„引用。
既然我们的String是ä¸å¯å˜çš„,那它内部还有很多substring, replace, replaceAll这些æ“作的方法。
这些方法好åƒä¼šæ”¹å˜String对象?怎么解释呢?
其实ä¸æ˜¯çš„,我们æ¯æ¬¡è°ƒç”¨replaceç‰æ–¹æ³•ï¼Œå…¶å®žä¼šåœ¨å †å†…å˜ä¸åˆ›å»ºäº†ä¸€ä¸ªæ–°çš„对象。然åŽå…¶value数组引用指å‘ä¸åŒçš„对象。
## 如何åœæ¢ä¸€ä¸ªæ£åœ¨è¿è¡Œçš„线程?
æœ‰å‡ ç§æ–¹å¼ã€‚
1ã€**使用线程的stop方法**。
使用stop()方法å¯ä»¥å¼ºåˆ¶ç»ˆæ¢çº¿ç¨‹ã€‚ä¸è¿‡stop是一个被废弃掉的方法,ä¸æŽ¨è使用。
使用Stop方法,会一直å‘ä¸Šä¼ æ’ThreadDeathå¼‚å¸¸ï¼Œä»Žè€Œä½¿å¾—ç›®æ ‡çº¿ç¨‹è§£é”所有é”ä½çš„监视器,å³é‡Šæ”¾æŽ‰æ‰€æœ‰çš„对象é”。使得之å‰è¢«é”ä½çš„对象得ä¸åˆ°åŒæ¥çš„处ç†ï¼Œå› æ¤å¯èƒ½ä¼šé€ æˆæ•°æ®ä¸ä¸€è‡´çš„问题。
2ã€**使用interrupt方法ä¸æ–线程**,该方法åªæ˜¯å‘Šè¯‰çº¿ç¨‹è¦ç»ˆæ¢ï¼Œä½†æœ€ç»ˆä½•æ—¶ç»ˆæ¢å–决于计算机。调用interrupt方法仅仅是在当å‰çº¿ç¨‹ä¸æ‰“了一个åœæ¢çš„æ ‡è®°ï¼Œå¹¶ä¸æ˜¯çœŸçš„åœæ¢çº¿ç¨‹ã€‚
接ç€è°ƒç”¨ Thread.currentThread().isInterrupted()方法,å¯ä»¥ç”¨æ¥åˆ¤æ–当å‰çº¿ç¨‹æ˜¯å¦è¢«ç»ˆæ¢ï¼Œé€šè¿‡è¿™ä¸ªåˆ¤æ–我们å¯ä»¥åšä¸€äº›ä¸šåŠ¡é€»è¾‘处ç†ï¼Œé€šå¸¸å¦‚æžœisInterrupted返回trueçš„è¯ï¼Œä¼šæŠ›ä¸€ä¸ªä¸æ–异常,然åŽé€šè¿‡try-catchæ•èŽ·ã€‚
3ã€**è®¾ç½®æ ‡å¿—ä½**
è®¾ç½®æ ‡å¿—ä½ï¼Œå½“æ ‡è¯†ä½ä¸ºæŸä¸ªå€¼æ—¶ï¼Œä½¿çº¿ç¨‹æ£å¸¸é€€å‡ºã€‚è®¾ç½®æ ‡å¿—ä½æ˜¯ç”¨åˆ°äº†å…±äº«å˜é‡çš„æ–¹å¼ï¼Œä¸ºäº†ä¿è¯å…±äº«å˜é‡åœ¨å†…å˜ä¸çš„å¯è§æ€§ï¼Œå¯ä»¥ä½¿ç”¨volatileä¿®é¥°å®ƒï¼Œè¿™æ ·çš„è¯ï¼Œå˜é‡å–值始终会从主å˜ä¸èŽ·å–最新值。
但是这ç§volatileæ ‡è®°å…±äº«å˜é‡çš„æ–¹å¼ï¼Œåœ¨çº¿ç¨‹å‘ç”Ÿé˜»å¡žæ—¶æ˜¯æ— æ³•å®Œæˆå“应的。比如调用Thread.sleep() 方法之åŽï¼Œçº¿ç¨‹å¤„于ä¸å¯è¿è¡ŒçŠ¶æ€ï¼Œå³ä¾¿æ˜¯ä¸»çº¿ç¨‹ä¿®æ”¹äº†å…±äº«å˜é‡çš„值,该线程æ¤æ—¶æ ¹æœ¬æ— æ³•æ£€æŸ¥å¾ªçŽ¯æ ‡å¿—ï¼Œæ‰€ä»¥ä¹Ÿå°±æ— æ³•å®žçŽ°çº¿ç¨‹ä¸æ–。
å› æ¤ï¼Œinterrupt() åŠ ä¸Šæ‰‹åŠ¨æŠ›å¼‚å¸¸çš„æ–¹å¼æ˜¯ç›®å‰ä¸æ–一个æ£åœ¨è¿è¡Œçš„线程**最为æ£ç¡®**çš„æ–¹å¼äº†ã€‚
## 什么是跨域?
简å•æ¥è®²ï¼Œè·¨åŸŸæ˜¯æŒ‡ä»Žä¸€ä¸ªåŸŸå的网页去请求å¦ä¸€ä¸ªåŸŸå的资æºã€‚由于有**åŒæºç–ç•¥**的关系,一般是ä¸å…许这么直接访问的。但是,很多场景ç»å¸¸ä¼šæœ‰è·¨åŸŸè®¿é—®çš„需求,比如,在å‰åŽç«¯åˆ†ç¦»çš„模å¼ä¸‹ï¼Œå‰åŽç«¯çš„域å是ä¸ä¸€è‡´çš„,æ¤æ—¶å°±ä¼šå‘生跨域问题。
**那什么是åŒæºç–略呢**?
所谓åŒæºæ˜¯æŒ‡"åè®®+域å+端å£"三者相åŒï¼Œå³ä¾¿ä¸¤ä¸ªä¸åŒçš„域å指å‘åŒä¸€ä¸ªip地å€ï¼Œä¹ŸéžåŒæºã€‚
åŒæºç–ç•¥é™åˆ¶ä»¥ä¸‹å‡ ç§è¡Œä¸ºï¼š
```mipsasm
1. Cookieã€LocalStorage å’Œ IndexDB æ— æ³•è¯»å–
2. DOM å’Œ Jså¯¹è±¡æ— æ³•èŽ·å¾—
3. AJAX 请求ä¸èƒ½å‘é€
```
**为什么è¦æœ‰åŒæºç–ç•¥**?
举个例å,å‡å¦‚ä½ åˆšåˆšåœ¨ç½‘é“¶è¾“å…¥è´¦å·å¯†ç ,查看了自己的余é¢ï¼Œç„¶åŽå†åŽ»è®¿é—®å…¶ä»–带颜色的网站,这个网站å¯ä»¥è®¿é—®åˆšåˆšçš„网银站点,并且获å–è´¦å·å¯†ç ,那åŽæžœå¯æƒ³è€ŒçŸ¥ã€‚å› æ¤ï¼Œä»Žå®‰å…¨çš„角度æ¥è®²ï¼ŒåŒæºç–略是有利于ä¿æŠ¤ç½‘站信æ¯çš„。
## 跨域问题怎么解决呢?
å—¯ï¼Œæœ‰ä»¥ä¸‹å‡ ç§æ–¹æ³•ï¼š
**CORS**,跨域资æºå…±äº«
CORS(Cross-origin resource sharing),跨域资æºå…±äº«ã€‚CORS 其实是æµè§ˆå™¨åˆ¶å®šçš„一个规范,æµè§ˆå™¨ä¼šè‡ªåŠ¨è¿›è¡Œ CORS 通信,它的实现主è¦åœ¨æœåŠ¡ç«¯ï¼Œé€šè¿‡ä¸€äº› HTTP Header æ¥é™åˆ¶å¯ä»¥è®¿é—®çš„åŸŸï¼Œä¾‹å¦‚é¡µé¢ A 需è¦è®¿é—® B æœåŠ¡å™¨ä¸Šçš„æ•°æ®ï¼Œå¦‚æžœ B æœåŠ¡å™¨ 上声明了å…许 A 的域å访问,那么从 A 到 B 的跨域请求就å¯ä»¥å®Œæˆã€‚
**@CrossOrigin注解**
如果项目使用的是Springboot,å¯ä»¥åœ¨Controllerç±»ä¸Šæ·»åŠ ä¸€ä¸ª @CrossOrigin(origins ="*") 注解就å¯ä»¥å®žçŽ°å¯¹å½“å‰controller çš„è·¨åŸŸè®¿é—®äº†ï¼Œå½“ç„¶è¿™ä¸ªæ ‡ç¾ä¹Ÿå¯ä»¥åŠ åˆ°æ–¹æ³•ä¸Šï¼Œæˆ–è€…ç›´æŽ¥åŠ åˆ°å…¥å£ç±»ä¸Šå¯¹æ‰€æœ‰æŽ¥å£è¿›è¡Œè·¨åŸŸå¤„ç†ã€‚注æ„SpringMVC的版本è¦åœ¨4.2或以上版本æ‰æ”¯æŒ@CrossOrigin。
**nginxåå‘代ç†æŽ¥å£è·¨åŸŸ**
nginxåå‘代ç†è·¨åŸŸåŽŸç†å¦‚下: 首先åŒæºç–略是æµè§ˆå™¨çš„安全ç–略,ä¸æ˜¯HTTPå议的一部分。æœåŠ¡å™¨ç«¯è°ƒç”¨HTTP接å£åªæ˜¯ä½¿ç”¨HTTPå议,ä¸ä¼šæ‰§è¡ŒJS脚本,ä¸éœ€è¦åŒæºç–略,也就ä¸å˜åœ¨è·¨è¶Šé—®é¢˜ã€‚
nginxåå‘代ç†æŽ¥å£è·¨åŸŸå®žçŽ°æ€è·¯å¦‚下:通过nginxé…置一个代ç†æœåŠ¡å™¨ï¼ˆåŸŸå与domain1相åŒï¼Œç«¯å£ä¸åŒï¼‰åšè·³æ¿æœºï¼Œåå‘代ç†è®¿é—®domain2接å£ï¼Œå¹¶ä¸”å¯ä»¥é¡ºä¾¿ä¿®æ”¹cookieä¸domainä¿¡æ¯ï¼Œæ–¹ä¾¿å½“å‰åŸŸcookie写入,实现跨域登录。
```js
// proxyæœåŠ¡å™¨
server {
listen 81;
server_name www.domain1.com;
location / {
proxy_pass http://www.domain2.com:8080; #åå‘代ç†
proxy_cookie_domain www.domain2.com www.domain1.com; #修改cookie里域å
index index.html index.htm;
add_header Access-Control-Allow-Origin http://www.domain1.com;
}
}
```
è¿™æ ·æˆ‘ä»¬çš„å‰ç«¯ä»£ç†åªè¦è®¿é—® http:www.domain1.com:81/*å°±å¯ä»¥äº†ã€‚
**通过jsonp跨域**
通常为了å‡è½»webæœåŠ¡å™¨çš„负载,我们把jsã€css,imgç‰é™æ€èµ„æºåˆ†ç¦»åˆ°å¦ä¸€å°ç‹¬ç«‹åŸŸåçš„æœåŠ¡å™¨ä¸Šï¼Œåœ¨html页é¢ä¸å†é€šè¿‡ç›¸åº”çš„æ ‡ç¾ä»Žä¸åŒåŸŸåä¸‹åŠ è½½é™æ€èµ„æºï¼Œè¿™æ˜¯æµè§ˆå™¨å…许的æ“作,基于æ¤åŽŸç†ï¼Œæˆ‘们å¯ä»¥é€šè¿‡åŠ¨æ€åˆ›å»ºscript,å†è¯·æ±‚一个带å‚网å€å®žçŽ°è·¨åŸŸé€šä¿¡ã€‚
